CNPJ Lakehouse: Risk Graph EngineCNPJ Lakehouse: Risk Graph Engine
Lakehouse local em PySpark para ingestão, padronização e grafo de risco de empresas.Local PySpark lakehouse for ingesting, standardizing and graph-scoring company data.
ProblemaProblem
A Receita Federal disponibiliza publicamente a base completa de CNPJs do Brasil: empresas, estabelecimentos, sócios, optantes do Simples/MEI, e tabelas de domínio (municípios, países, naturezas jurídicas, qualificações, CNAEs). São milhões de registros brutos, sem padronização de tipos, com campos sensíveis (CPF, CNPJ) que precisam de tratamento cuidadoso, e sem nenhuma estrutura pronta para análise relacional entre empresas e seus sócios.Brazil's federal revenue service (Receita Federal) publishes the country's full CNPJ registry: companies, establishments, partners, Simples/MEI tax regime status, and reference tables (municipalities, countries, legal nature, qualifications, economic activity codes). It's millions of raw records, with no type standardization, sensitive fields (CPF, CNPJ) that need careful handling, and no ready structure for relational analysis between companies and their partners.
Sem uma plataforma de dados organizada, não é viável montar uma visão confiável de quem é sócio de quem, identificar redes societárias (ex.: uma pessoa com participação em dezenas de empresas), ou calcular um score de risco que cruze porte, atividade, situação cadastral e histórico, já que tudo isso exige um pipeline de dados robusto, não só consultas pontuais.Without an organized data platform, there's no practical way to build a reliable view of who owns what, identify corporate networks (e.g., one person holding stakes in dozens of companies), or compute a risk score that crosses company size, activity, registration status and history, since that requires a real data pipeline, not just ad-hoc queries.
SoluçãoSolution
Arquitetei e implementei a base de uma plataforma de dados local, Spark-first, pensada para um time de 4 engenheiros trabalharem em paralelo: runtime PySpark + Jupyter para desenvolvimento interativo, MinIO como data lake compatível com S3, e Docker Compose subindo tudo com um único comando (start_local), incluindo o bootstrap automático dos buckets (raw, bronze, silver, gold, checkpoints).I architected and built the foundation of a local, Spark-first data platform designed for a team of 4 engineers to work in parallel: a PySpark + Jupyter runtime for interactive development, MinIO as an S3-compatible data lake, and Docker Compose spinning everything up with a single command (start_local), including automatic bootstrap of the raw/bronze/silver/gold/checkpoints buckets.
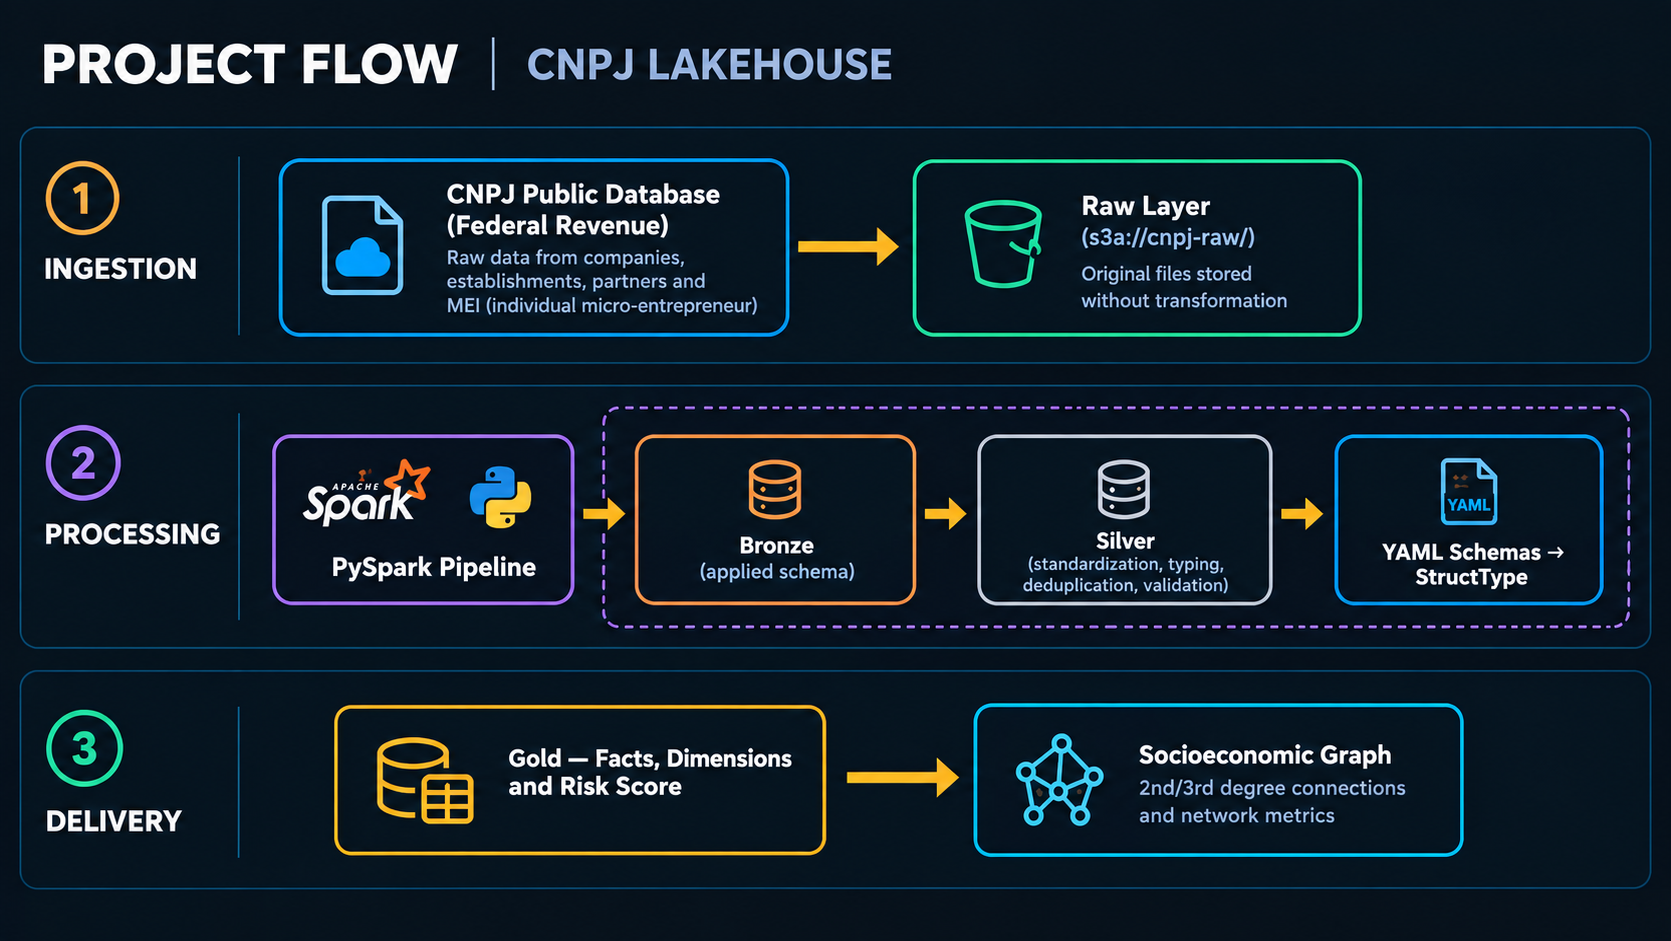
Os dados seguem a arquitetura medalhão: a camada raw preserva os arquivos originais sem transformação; bronze aplica o schema de origem; silver normaliza, tipa, deduplica e valida (CPF/CNPJ sempre como string, pra não perder zeros à esquerda); gold publica fatos, dimensões, score de risco e os datasets de grafo. Todo schema é declarado em YAML e convertido para StructType do Spark por um conversor próprio, com testes de smoke garantindo que qualquer mudança de schema não quebra os jobs.Data follows the medallion architecture: the raw layer preserves original files untouched; bronze applies the source schema; silver normalizes, types, deduplicates and validates (CPF/CNPJ always kept as strings, to avoid losing leading zeros); gold publishes facts, dimensions, the risk score and the graph datasets. Every schema is declared in YAML and converted into a Spark StructType by a custom converter, with smoke tests ensuring schema changes never silently break jobs.
A camada de grafo relaciona sócios e empresas pra mapear conexões diretas e indiretas (2º e 3º grau), permitindo enxergar redes societárias que não apareceriam numa consulta simples, além de métricas de rede (centralidade, densidade) por grupo. Todo o fluxo de trabalho do time segue convenções específicas: branches por task, commits atômicos, PRs com evidência de execução local, e um board dividido por camada (bronze/silver/gold/grafo) e responsável.The graph layer relates partners and companies to map direct and indirect connections (2nd and 3rd degree), surfacing corporate networks that wouldn't show up in a simple query, along with network metrics (centrality, density) per group. The team's whole workflow follows explicit conventions: one branch per task, atomic commits, PRs with local execution evidence, and a board split by layer (bronze/silver/gold/graph) and owner.
ResultadosResults
Esse projeto ainda está em desenvolvimento, e o resultado até aqui é a fundação técnica: ambiente local reproduzível em um único comando, com Spark, Jupyter e MinIO funcionando de ponta a ponta, e schemas de bronze já modelados e versionados em YAML com testes de smoke.This project is still in progress, and the result so far is the technical foundation: a local, reproducible environment that comes up with a single command, with Spark, Jupyter and MinIO working end-to-end, and bronze schemas already modeled and YAML-versioned with smoke tests.
Também ficou definido e documentado todo o processo de colaboração do time (branches, commits, PRs, board de tasks por camada e responsável), o que permite que os 4 engenheiros avancem em paralelo em bronze, silver, gold e grafo sem travar uns aos outros, com a base estrutural pronta pra escalar o pipeline completo.The team's full collaboration process is also defined and documented (branches, commits, PRs, a task board split by layer and owner), letting the 4 engineers move in parallel across bronze, silver, gold and graph work without blocking each other, with the structural foundation ready to scale into the full pipeline.
TecnologiasTechnologies
Fluxograma de ArquiteturaArchitecture Flowchart
RawRaw
Arquivos originais da Receita Federal preservados sem transformação em s3a://cnpj-raw/.Original Receita Federal files preserved untouched in s3a://cnpj-raw/.
BronzeBronze
Schema de origem aplicado (YAML → StructType), dados gravados fiéis ao layout original.Source schema applied (YAML → StructType), data written true to the original layout.
SilverSilver
Normalização, tipagem, deduplicação e validação, com CPF/CNPJ como string para não perder zeros à esquerda.Normalization, typing, deduplication and validation, with CPF/CNPJ kept as strings to avoid losing leading zeros.
Gold: Fatos e DimensõesGold: Facts & Dimensions
Fatos de empresa/estabelecimento, dimensões e score de risco publicados para consumo analítico.Company/establishment facts, dimensions and the risk score published for analytical consumption.
Grafo de SóciosPartner Graph
Vértices e arestas sócio-empresa, conexões de 2º/3º grau e métricas de rede por grupo societário.Partner-company vertices and edges, 2nd/3rd degree connections and network metrics per corporate group.